Препринтът LIBERO-RIG, подаден в arXiv на 13 октомври 2026 г., изследва промени в оборудването при запазени роботни задачи. Авторите тестват девет vision-language-action модела по единадесет направления и пет степени на промяна. Отчитат общ успех 0,932 при номинални условия, 0,767 при средна и 0,509 при най-висока тежест. Това са резултати на авторите в симулационна среда; редакцията не е повторила тестовете.
Задачата може да остане същата, средата — не
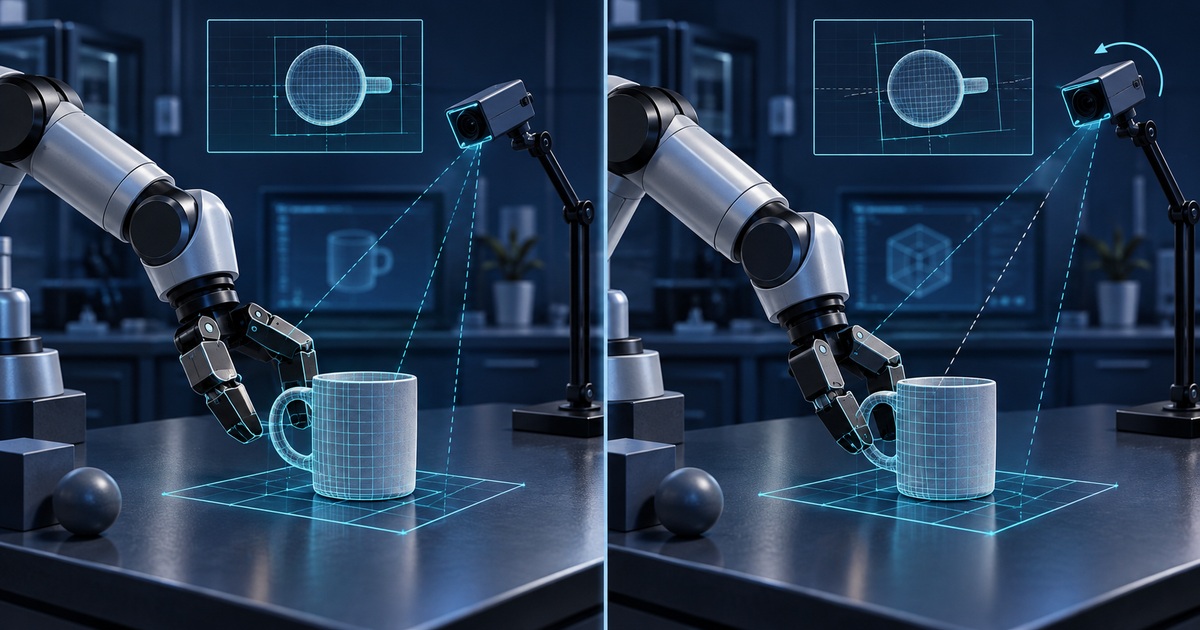
В нашия редакционен прочит оценката е важна, защото въпросът към робота не винаги се променя, когато се промени оборудването. Чашата може да трябва да бъде преместена на същото място, но камерата вече да гледа от различен ъгъл. Това е обяснителен пример, не допълнителен измерен резултат от препринта.
Полезният тест трябва да показва какво точно е променено. Ако едновременно се сменят предметът, инструкцията и настройката, не е лесно да се установи причината за неуспеха. Бихме запазвали отделни записи за всяка конфигурация и проверявали дали самата задача остава изпълнима. Така общият процент може да се свърже с конкретно ограничение, вместо да се превърне в етикет за целия модел.
Какво означава LIBERO
Оригиналното хранилище на LIBERO описва benchmark за пренос на знания в многозадачно и продължаващо роботно обучение. То предоставя задачи и човешки демонстрации чрез телеоперация, с набори за пространствени отношения, предмети и цели. Това е контекст за основата на новото изследване, не независимо повторение на LIBERO-RIG.
Според нашия анализ общите задачи са полезни за сравнение, когато протоколът е ясно запазен. В същото време мястото в класация трябва да се чете заедно с начина на обучение и изпълнение. Ако различни екипи използват различни настройки, близките резултати не доказват непременно разлика в способностите. За практическа оценка е необходима и проверка на условия, близки до планираното приложение.
По-ранен контекст за ограниченията на benchmark-ите
Отделен препринт от 2 юни, What Are We Actually Benchmarking in Robot Manipulation?, разглежда риск от преки пътища, статистически неубедителни разлики, постепенно пренастройване и зависимост от данните. Авторите предлагат диагностични проверки. Това е различно изследване и не трябва да се смесва с новите числени резултати.
Нашият извод от този контекст е, че добрата оценка изисква повече от висок процент. Тя трябва да обясни коя способност е измерена, кои алтернативни обяснения са проверени и какво не е включено. Повторението на позната задача може да е полезен тест, без автоматично да доказва общо разбиране на непозната среда.
Какво следва за разработчиците
Бихме използвали такъв benchmark като сигнал къде да насочим изпитванията, а не като готово разрешение за внедряване. При реална машина трябва да се оценят конкретните сензори, механика, работна зона и безопасно спиране. Симулационната проверка и изпитването на терен отговарят на различни въпроси.
Новината е полезна именно с промяната на фокуса: AI роботът се оценява заедно с настройката, от която зависи действието му. Нито един от посочените проценти не е универсална вероятност за успех във фабрика или дом. Следващата проверима стъпка е независимо повторение на протокола и ясно сравнение с физически изпитвания, преди резултатът да бъде използван за широки обещания за автономност.
Източници: LIBERO-RIG — original preprint, LIBERO — original benchmark repository, What Are We Actually Benchmarking in Robot Manipulation?.
Редакционна проверка: 2026-10-14T16:34:39.030582+00:00 (UTC).