Дневникът на LongCat API отбелязва на 2 ноември пускането на LongCat 2.5. Отделният предварителен вариант е записан още на 25 септември. Следователно сегашното съобщение не е първата поява на името 2.5, а нов етап на достъпност. Доставчикът го насочва към мултимодални и продължителни задачи с инструменти.
Какво описва моделът
Техническият текст от 1 ноември посочва 1,6 трилиона общи параметри и приблизително 48 милиарда активирани за токен. Изображенията се представят чрез дискретни токени, а обучението включва дълги последователности на действия. Това са данни на разработчика. Те не са независимо измерване на качеството върху произволен чужд проект.
На същата страница GitHub и Hugging Face са обозначени като предстоящи. Не представяме API услугата като вече проверено издание с публични тегла. Разликата определя какво читателят може действително да прегледа или изпълни сам: достъпът до отговори през услуга не предоставя автоматично артефакт за локално внедряване.
Какво е проверимо за интеграцията
Публичното API ръководство изброява LongCat-2.5, формати за OpenAI Chat Completions и Anthropic Messages, контекст до един милион токена и изход до 128 хиляди токена. При ограничаване на заявките е описан HTTP 429. SIExpo прочете документацията, но не създаде ключ, не изпрати частен код и не извърши платен тест.
Съвместимият формат улеснява свързването на клиент, но сам по себе си не доказва еднакво поведение. Екипът трябва да провери кои полета, инструменти и ограничения използва собственото му приложение. Наличен отговор на кратко запитване също не удостоверява, че целият работен поток с файлове и външни инструменти е завършен правилно.
Пример за смислено сравнение
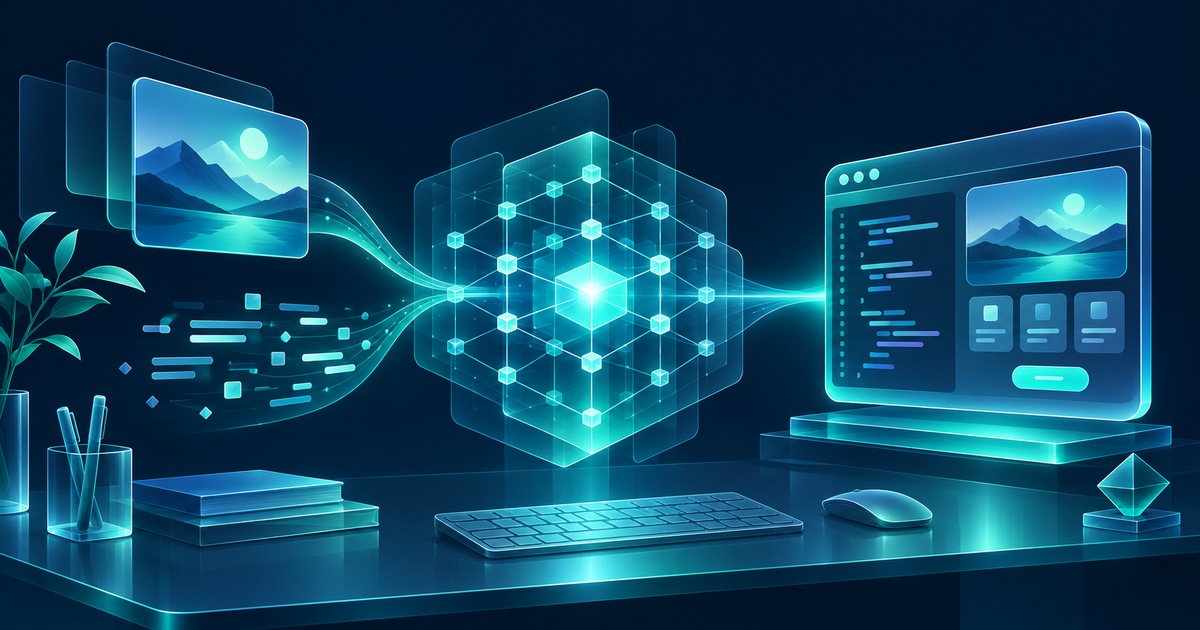
Нашето предложение е оценката да започне с ограничена реална задача: от изображение на желан интерфейс до промяна в тестово копие на проект. Критерият би включвал не само визуално сходство, но и работещи взаимодействия, съществуващи проверки и ясно описание на направените промени. Това е редакционен пример, а не измерен резултат на LongCat.
За по-дълга работа бихме записвали успешните и неуспешните стъпки, общото време и необходимите човешки корекции. Полезно е еднакъв бюджет и еднакви разрешения да важат за сравняваните системи. Иначе разлика в броя разрешени опити лесно може да се сбърка с разлика в способностите на модела.
Големият контекст също не е гаранция, че важен детайл ще бъде използван правилно. В предложен тест може да има променено изискване по средата на задачата и проверка дали крайният резултат го спазва. Това би оценило употребата на контекста, вместо само възможността той да бъде приет.
Новината е проверимото пускане на услугата и описаната техническа посока. Практическото предимство, надеждността при дълги задачи и възможността за локално внедряване остават отделни въпроси, които не решаваме с фирмена демонстрация.
Редакционна проверка: 2026-11-02T17:07:21.522703+00:00 (UTC; Europe/Sofia е UTC+02:00).