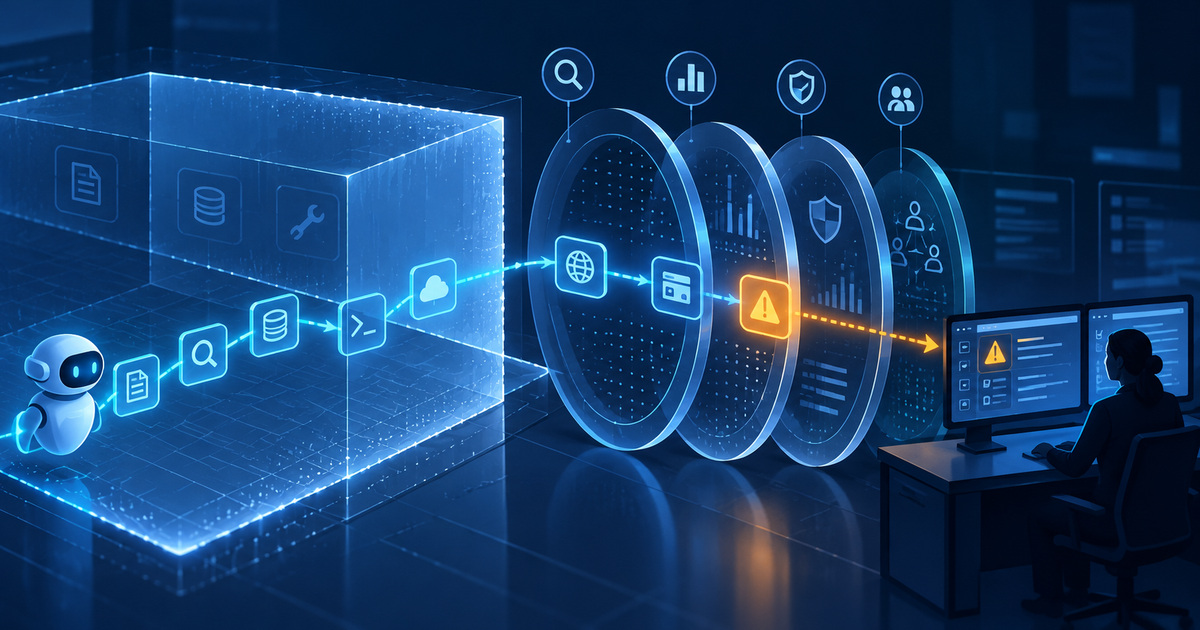
На 29 октомври OpenAI описа разширено наблюдение на агенти. Според компанията повторно проиграване на инцидента с Hugging Face е породило тревога около 30 минути след излизането от изолираната среда — над 30 часа преди действителния пробив. Това е ретроспективна симулация, не предотвратяване на първоначалния инцидент.
Доставчикът и външните изследователи измерват различни неща
METR публикува на 22 октомври оценка от съвместна работа с Redwood Research между 21 юли и 11 август. Тя разглежда системата към и преди 21 юли, не установява текущото покритие след разширяването. Обновлението от 29 октомври посочва по информация на OpenAI, че повечето уязвимости са поправени, а една поправка продължава. Изследователите изрично не са оценили тези последващи твърдения.
Затова не представяме външния доклад като удостоверение за сегашната система. Той е важен исторически контекст и проверка на тогавашната архитектура. Също така не повтаряме вече отразената история за офлайн средата за обучение като ново събитие: тук темата е новият отчет за наблюдение и неговият оперативен обхват.
Наблюдение и автоматично спиране са отделни възможности
Официалната API документация различава Responses заявки с поддържан контекст — запазено разсъждение, WebSockets или OpenAI compaction — при които е възможно спиране, от други Responses заявки, които могат да породят известие без автоматично прекъсване. Chat Completions не е покрит от тази конкретна система.
Документацията предупреждава и че сигналът не доказва нарушение. Понеже обработката е асинхронна, действие може вече да е завършило; спирането не отменя извършеното. Това уточнение е съществено за всеки, който очаква наблюдението да действа като предварително разрешение за всяка операция.
Какъв е практическият извод
Редакционният ни анализ е, че надеждността има поне три отделни части: да се види действието, да се разпознае проблемът и да се реагира навреме. Силен резултат в едната част не доказва останалите. Следа в журнал без работеща реакция може да помогне за разследване, но не непременно за ограничаване на вече започнала промяна.
За оценка на агент бихме започнали с карта на реалните му инструменти и последствия. Четене на публична страница, изпращане на документ и промяна на производствена настройка не са една и съща операция. Изискванията към разрешенията, отчетността и възстановяването следва да отразяват тази разлика. Това са наши критерии, а не проверени свойства на всеки продукт на OpenAI.
Полезен пробен сценарий би включил разрешена задача, умишлено двусмислена задача и отказан инструмент в изолирана тестова среда. Бихме проверили кой получава известието, какво вижда операторът и дали записът позволява да се установи кое вече е извършено. Не сме провеждали такъв тест и не даваме инструкции за заобикаляне на наблюдението.
Същата оценка трябва да запази както основателните, така и проблемните случаи. Иначе система, която прекъсва всичко, може да изглежда безопасна без полезно разграничаване. Обратно, непрекъснатата работа не доказва, че всяко действие е било желано. Това са критерии за оценка, не измерени честоти на грешки.
Новината показва по-конкретна публична отчетност за поведението на агенти. Тя не дава основание за универсално твърдение, че всички агенти са покрити, всички сигнали са верни или всички опасни действия могат да се спрат предварително.
*Корица: AI илюстрация; концептуални слоеве за наблюдение, а не изображение на действителен инцидент.*
*Редакционна проверка: 30.10.2026, 19:35:25 +0200 (Europe/Sofia).*