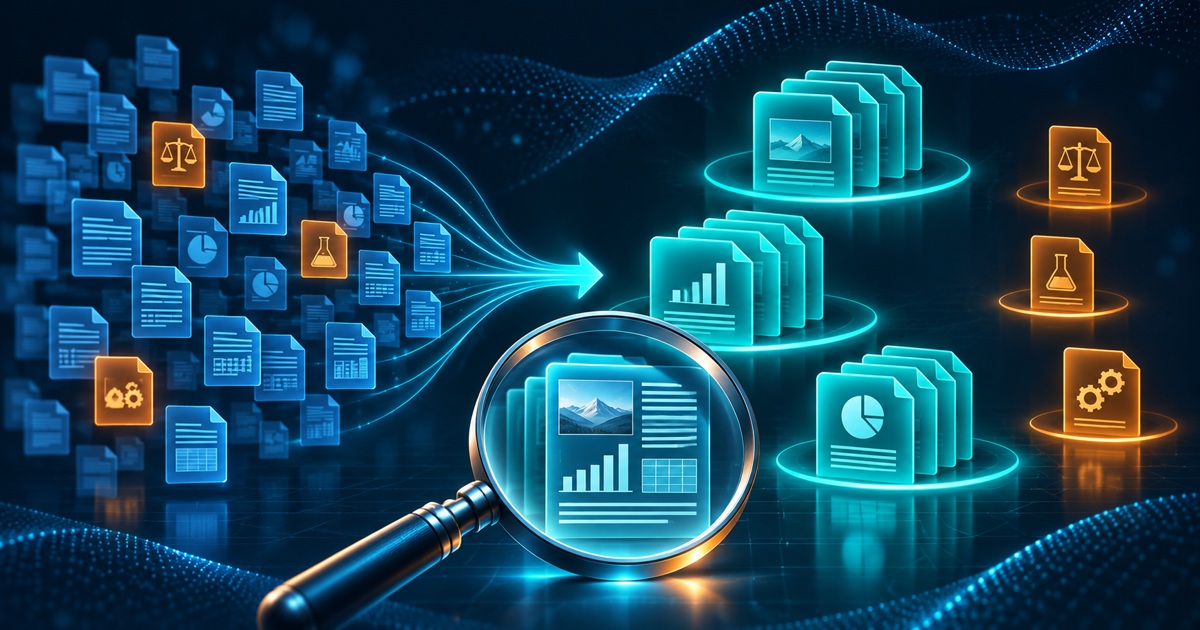
Tom Aarsen публикува на 11 ноември технически разбор за обучение, което подготвя многовекторни embedding модели за token pooling. Методът обединява сходни документни вектори, а обучението учи представянето да остане полезно след това обединяване. Това засяга търсенето на информация, а не компресиране на текста в разговор с генеративен модел.
В описаната авторска оценка при pool_factor=4 запазването на съответния некoмпресиран NanoBEIR nDCG@10 резултат се повишава от 94,6% до 97,8%. Това е относително запазване на метрика за подреждане в определен експеримент, не 97,8% универсална точност на отговорите. Публичният учебен скрипт дава конкретен път към сравняване на двата режима.
Какво точно става по-малко
За редакционния прочит е важно да се разделят три неща: брой вектори, размер на всеки вектор и точност на неговите числа. Намаляването на едното не означава автоматично еднакво намаляване на целия индекс. Метаданни, текст, структури за търсене и работна памет остават отделни части от системата.
Представете си документ с няколко почти еднакви описания и едно решаващо изключение. Обединяването може да премахне излишното повторение, но не бива да скрие изключението, когато въпросът е точно за него. Това е наш пример за проверка на качеството, не конкретен провал, отчетен от автора.
Сравнете правилните базови линии
Собствена сметка помага за правилното четене на проценти. Ако некoмпресираният резултат условно е 50 точки, запазване на 98% от него означава 49 точки, не 98 точки. Затова и двете абсолютни стойности са нужни, когато се оценява практическата загуба. Това е аритметичен пример, отделен от публикуваните измервания.
За реална база бихме сравнили еднакви заявки, един и същ корпус и еднаква схема за оценяване. Отделно трябва да се проверят редки термини, отрицания, дълги документи и близки, но различни продукти. Средна стойност може да изглежда добра, докато малка важна група заявки се влошава.
След това идва крайната цена. По-малко съхранение може да има полза, но добавеното индексиране, клъстериране или обновяване също изисква ресурси. Полезни показатели са размер на целия индекс, време за изграждане, latency на заявките и качеството на намерените доказателства. Генерираният отговор трябва да се оценява отделно от самото извличане.
SIExpo е прегледал описанието и публичния скрипт статично, без обучение или собствен бенчмарк. Изводът е конкретен: компресирането заслужава да бъде част от целта на обучението, но рекламна дроб за броя вектори не замества оценка върху действителните документи и въпроси на приложението.
Редакционна проверка: 2026-11-17T07:54:00.882419+00:00.