Един персонаж, няколко различни системи
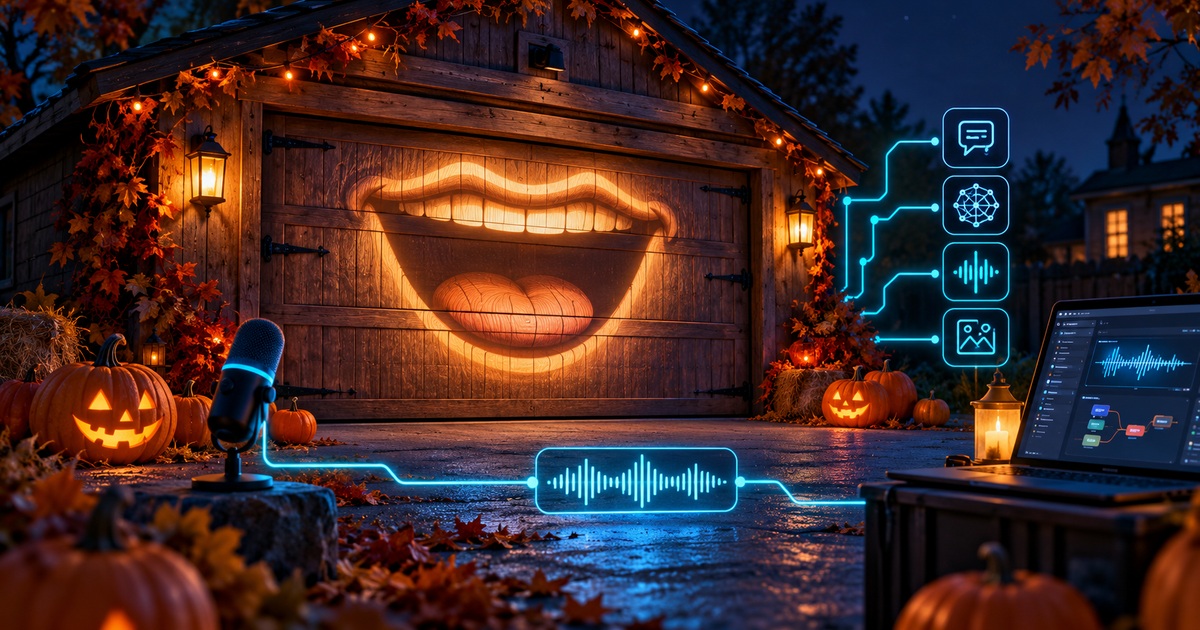
В публикация от 30 октомври в организацията на NVIDIA в Hugging Face Рик Гранди представя MonsterHouse — интерактивна проекция, която превръща гаражна врата в говорещ персонаж. Това е личен инженерен проект на служител на компанията, а не пуснат масов продукт или проверена от SIExpo инсталация.
В описанието има отделни етапи за разпознаване на реч, генериране на отговор, синтез на глас и анимация. Така думата „агент“ не обозначава един-единствен модел, който върши всичко. Авторът използва Nemotron Voice Agent като основа, а характера и поведението оформя с приложение и допълнителна настройка.
Публичен модел не означава готово представление
Хранилището Nemotron Voice Agent съдържа примерни конфигурации за различни гласови приложения. Те имат различни хардуерни и софтуерни изисквания. Профил с облачни услуги и профил с локално изпълнение не трябва да бъдат описвани като еднакви по достъп, памет и зависимости.
Audio2Face-3D е отделен набор от модели и инструменти за лицева анимация от звук. Съществуването на такива компоненти обяснява как може да се сглоби система, но не премахва работата по сцена, синхронизация и управление.
Авторът изрично уточнява, че кодът на MonsterHouse не е пакетиран за публично издаване. Затова материалът не предлага обещание „изтегли и включи същата къща“.
Къде се усеща забавянето
Редакционен пример: посетител задава въпрос, разпознаването приключва, моделът генерира реплика, гласът започва да звучи, а изображението трябва да се движи в същия момент. Добро време само за езиковия модел не доказва, че целият разговор е естествен. Човекът усеща общото изчакване и прекъсванията между етапите.
За подобен прототип бихме измервали времето от края на изказването до първия чуваем звук, поведението при фонов шум и възстановяването след прекъснат компонент. Това са предложени проверки, а не резултати от наш тест. Предварително подготвените реплики могат да дадат предвидим отговор в чести ситуации, но трябва да се отличават от свободно генериран разговор.
Какво демонстрацията още не доказва
Публикацията разграничава синтетичен визуален тест от изпитание с истински посетители и нощно осветление. Разказът за характер и настроение също не е доказателство за надеждно разбиране на всяка ситуация. Не пренасяме примерните времена към друго оборудване или натоварване.
Интересният извод е архитектурен: убедителният гласов персонаж изисква управление на състоянието, аудио и визуална синхронизация и удобен начин за човешка намеса. Локалният хардуер дава контрол върху изпълнението; резултатът зависи от целия процес. SIExpo разглежда проекта като полезна демонстрация на интеграция, със съвсем отделна задача по превръщането ѝ в поддържана услуга.