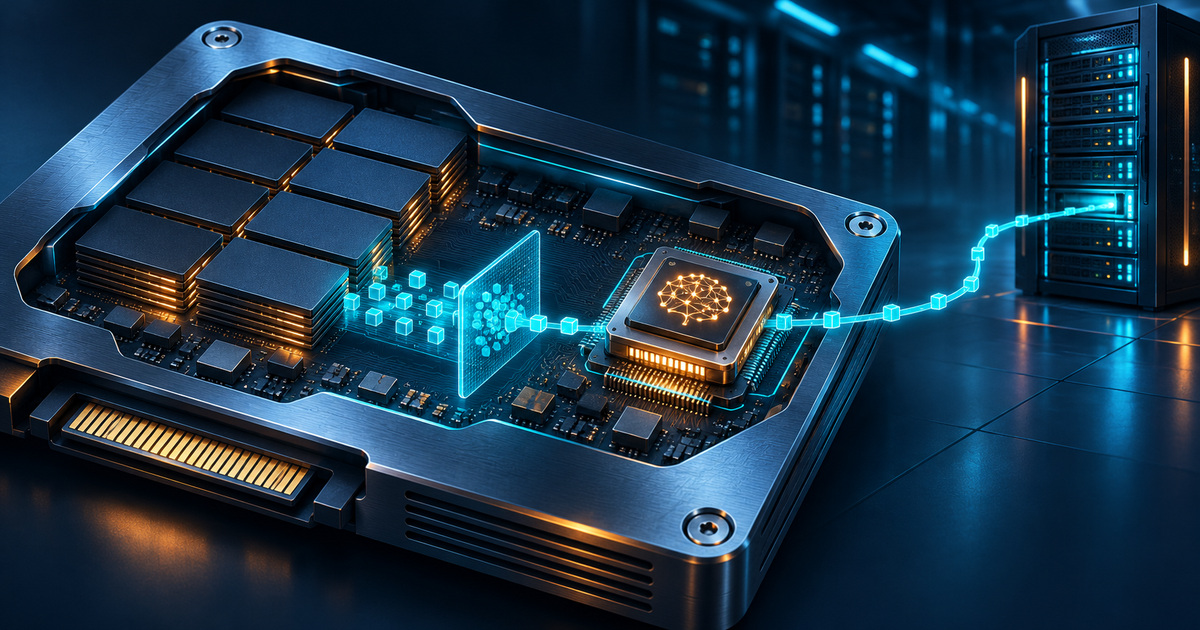
Phison представи на 17 ноември на SC26 архитектура за изчисления в самото SSD. Компанията описва NPU и 64 GB памет с пропускателна способност 130 GB/s, както и поддръжка на PyTorch, vLLM, OpenVINO и llama.cpp. Идеята е устройството да обработва данни и да връща нужния резултат, вместо целият набор да преминава към хоста. Посоченото намаляване на преноса от 10 до 100 пъти е фирмена оценка за подходящи натоварвания.
Калдата отразява разработката на 22 ноември и обръща внимание на липсващите продуктови подробности. В официалното съобщение също има уточнение, че много от показаните функции още се разработват. Следователно това е архитектурно предложение с технически параметри, а не достатъчна основа за избор на готово устройство по цена и производителност.
Къде може да има смисъл
Следващият пример е редакционно обяснение на принципа, не публикуван тест на Phison. Представете си голям архив, от който приложението търси само записи с определени свойства. При един подход целият архив се прочита от хоста, който прилага филтъра. При друг подход част от филтрирането се извършва близо до данните и към приложението пътува по-малък резултат.
Във втория случай връзката към хоста може да бъде натоварена по-слабо. Но ако предварителната обработка отнема много време, ако заявката се променя постоянно или ако почти всички записи са необходими, ползата може да бъде различна. Архитектурната идея трябва да се проверява с конкретен поток от данни. Самото наличие на изчислителен блок в диска не определя кой подход ще спечели.
Важно е и какво наричаме резултат: списък от подходящи записи, векторно представяне или текстов отговор са различни продукти на обработката. За реална интеграция разработчикът трябва да знае какви операции се изпълняват в устройството, как се подават входовете и как се получават грешките. Изброяването на познати рамки е отправна точка за тези въпроси, не техният пълен отговор.
Три числа, три различни измервания
Капацитетът на паметта, нейната пропускателна способност и времето за завършване на една заявка измерват различни свойства. Голям вътрешен трансфер не показва сам по себе си колко заявки ще обслужи цялото приложение. По същия начин по-малко прехвърлени байтове не означава автоматично толкова пъти повече генерирани токени.
Това разграничение е особено полезно при сравнение на предложението със сървър с отделен ускорител. Честното сравнение започва от една и съща задача и един и същ набор от данни. После включва целия път: четене, подготовка, изчисление и предаване на резултата. Ако измерим само най-бързия вътрешен етап, можем да пропуснем мястото, на което потребителят всъщност чака.
Какво би направило бъдещ тест убедителен
Полезен изпитателен сценарий би посочил размера на архива, дела върнати данни, състоянието на кеша и броя едновременни заявки. Отделно трябва да се сравнява правилността на отговорите. Ако по-малкият трансфер се получава чрез пропускане на необходими записи, това не е същият резултат с по-добра ефективност.
За експлоатацията има и практически въпроси: как се обновява изпълняваният софтуер, как се наблюдава натоварването и какво се случва при прекъсване на задача. Това са предложени от редакцията критерии за бъдеща оценка, а не установени дефекти в конкретен продукт. Преди да има достатъчно публични измервания, те остават въпроси към разработката.
Същото важи за енергията. Оценката трябва да включи устройството и хоста за завършената работа, вместо само консумацията на един компонент. Преместването на обработката променя разпределението на разходите; дали намалява общия разход е проверим резултат, който не може да се изведе единствено от блокова схема.
Показаното от Phison е интересно именно като опит да се реши проблемът с движението на данните. Следващата важна стъпка е да се види кои натоварвания печелят, при какъв софтуерен интерфейс и с каква обща цена на изпълнение. Дотогава обещаното намаляване на трансфера трябва да се чете в неговия конкретен обхват, без да се превръща в универсално ускорение на AI.