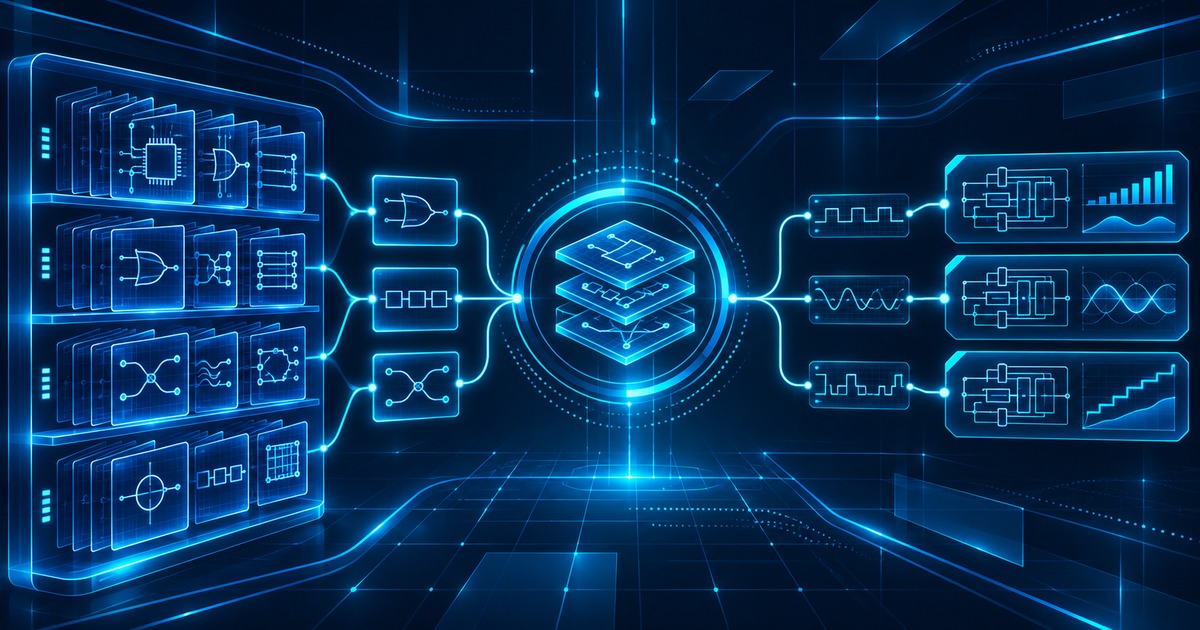
На 2 ноември 2026 г. Тайминг Лу, Ци Сю, Джъган Хуа и Джуан Лиу публикуваха в arXiv предварително изследване за Strategist. Системата използва AI агент, за да създава и изпитва програми, които управляват начина, по който други езикови модели решават задачи. Изследователите запазват изпитаните програми в обща библиотека, така че следваща задача да може да използва част от предишната работа.
Какво се променя
Един и същ езиков модел може да получи въпроса веднъж или да бъде извикан няколко пъти. Софтуерът около него може например да поиска две независими решения и да провери къде се разминават. Така изборът на процедура променя както качеството на отговора, така и разхода за изпълнение. При Strategist теглата на моделите остават фиксирани. Променя се кодът, който организира техните извиквания.
В началото на изпитване системата получава задача и примери за разработка. Тя намира подходящи програми в библиотеката, създава кандидати, изпълнява ги върху примери и сравнява измерените резултати. Кандидатите могат да използват по-рано създадени програми чрез общ интерфейс. В библиотеката се записват измервания и бележки от изпитването, включително за кандидати, които не печелят. Така следващо търсене може да започне от вече изпробвана идея.
По-ранният проект DSPy също разглежда автоматично настройване на програми с езикови модели по зададена метрика. Strategist поставя акцента върху това как изпълнимите стратегии могат да се съхраняват и комбинират между различни задачи. Двата подхода дават контекст за по-широкия въпрос как да се измерва и подобрява софтуерът около моделите.
Как да се четат числата
Авторите сравняват системата върху 30 теста и съобщават средна точност от 74,7% при 74,0% за референтния подход. Отчитат и 39% по-нисък среден претеглен разход за изпълнение. Според тяхната дефиниция за победа Strategist води в 24 теста. Дефиницията допуска печалба по разход при близка точност, затова числото 24 не означава, че системата е по-точна във всеки от тези тестове. Авторите посочват и задачи, при които разходът се повишава или спестяването идва с компромис в точността.
Самото търсене изисква отделен бюджет. За примерен тест със 100 реда във всяка част от данните за разработка екипът описва около 20 000 изпълнения на кандидат върху пример при пълно търсене. Следователно 39% по-нисък разход за изпълнение на намерена стратегия не измерва пълната цена за намирането ѝ. При задача, която се повтаря много пъти, търсенето може да се изплати чрез по-евтини последващи изпълнения. За малък обем предварителният разход може да остане по-голям от спестеното.
Изследователите тестват и извличане на готови стратегии за десет отделени теста, както и пренасяне към други модели. Това показва как екипът е проверил идеята за повторно използване в рамките на своя експеримент. Публикацията е предварителна. За употреба в конкретна система е нужно да се измерят общият разход, точността върху собствени задачи и поведението на генерирания код при реалните ограничения за достъп.