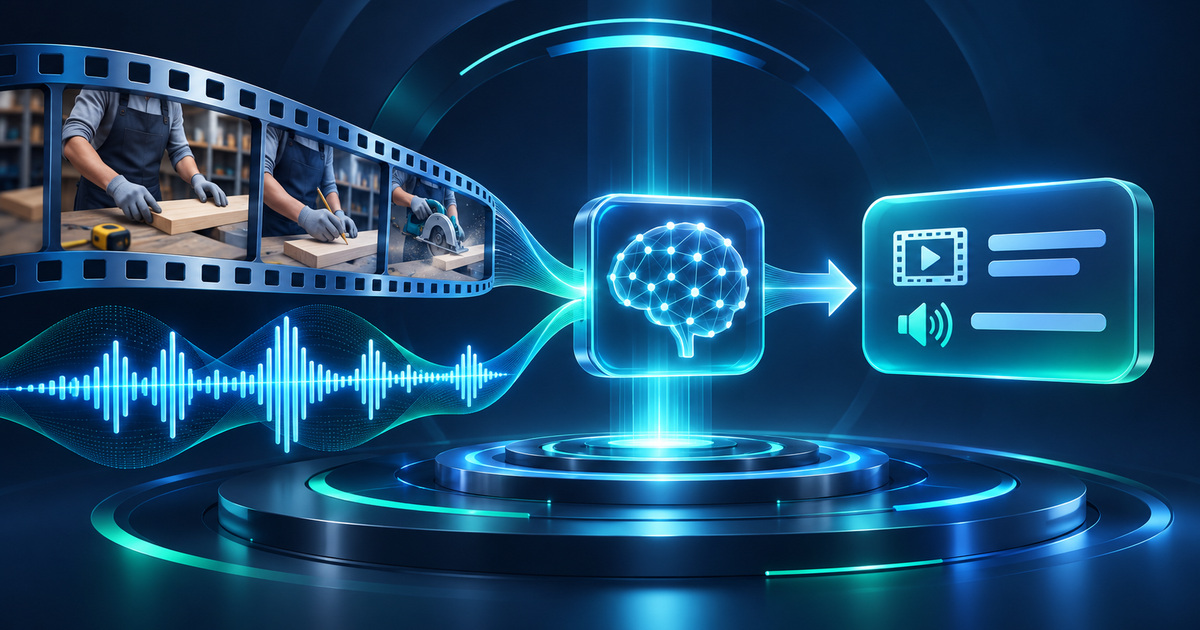
Tencent представя WeMM-Video в предпечат от 19 ноември. Семейството е насочено към съвместно аудио-визуално разбиране и работа на китайски и английски. Входът може да включва текст, изображение, звук и видео, а изходът е текст. Това е система за интерпретация, не генератор на видеоклипове.
Публикувани са варианти 2B, 4B, 9B и 35B-A3B и режими за пряк отговор или по-разгърнато разсъждение. Тези означения описват различни конфигурации; не установяват еднаква цена или надеждност за всяка задача. Представените резултати са авторски, без независима репликация от SIExpo.
Защо едната модалност не замества другата
Нашият практически пример е клип, в който човек изпълнява действие и едновременно го коментира. Описанието може да бъде проверено поотделно спрямо кадрите и звука. Ако двете подсказки си противоречат, полезният отговор би запазил това противоречие, вместо да го изглажда в убедителен общ разказ. Това е предложен критерий, а не измерен резултат на WeMM-Video.
За пилот могат да се сравнят едни и същи клипове със звук и без него. Така екипът проверява дали допълнителният канал действително помага за зададените въпроси. Не е необходимо обща benchmark позиция да се превръща в обещание за всяка местна колекция, език или вид запис.
Изпълнението има собствена среда
Хранилището описва Python 3.12, NVIDIA CUDA 12.9 и FFmpeg като част от примерната среда. Публикуваният код е с Apache 2.0; конкретните checkpoints и зависимостите заслужават отделен преглед. Зареждането на допълнителен моделeн код следва да бъде осъзнато действие с проверена версия, а не автоматично доверие към всеки файл.
Предлагаме за оценката да се запазят версията на теглата, обработката на входа, зададените въпроси и очакваните основания за отговора. Ако резултатът посочва случило се действие, проверяващият трябва да може да намери доказателството в конкретна част от записа. Пропуските и неясните отговори също са част от отчета.
Границата на приложението
Подходът може да бъде интересен за търсене и описание на аудио-визуални материали, но изборът зависи от реалната задача и правата върху данните. Не приемаме, че системата безпогрешно установява самоличност на говорещ или причината за събитие. Новото семейство предоставя инструменти за изследване на общото разбиране; достоверността на отделния отговор остава нещо, което приложението трябва да проверява.